“한빛미디어 서평단 <나는리뷰어다> 활동을 위해서 책을 협찬받아 작성된 서평입니다.”
요즘 LLM을 사용하면서 Transformer, BPE, RoPE, SFT, DPO, GRPO 같은 용어를 접하는 일은 어렵지 않다. 논문을 읽거나 새로운 모델의 기술 소개를 보다 보면 "이번에는 RoPE를 이렇게 바꿨다", "AdamW 대신 다른 옵티마이저를 사용했다", "RLHF 대신 DPO를 적용했다"는 설명도 자주 나온다.
각각의 용어가 무엇인지는 따로 찾아볼 수 있지만, 항상 조금 아쉬웠던 건 이 기술들이 실제 언어 모델 안에서 어디에 들어가고 서로 어떻게 연결되는가였다.
<밑바닥부터 시작하는 딥러닝 6>은 바로 그 부분을 꽤 제대로 보여주는 책이었다. 완성된 라이브러리를 가져다가 모델을 학습시키는 것이 아니라, 토크나이저부터 모델, 학습까지 직접 하나씩 만들어간다. 제목 그대로 정말 '밑바닥부터' LLM 한 개가 만들어지는 과정을 따라가는 책이다.
BPE도 라이브러리 호출이 아니라 토큰 쌍을 세는 것부터 시작한다
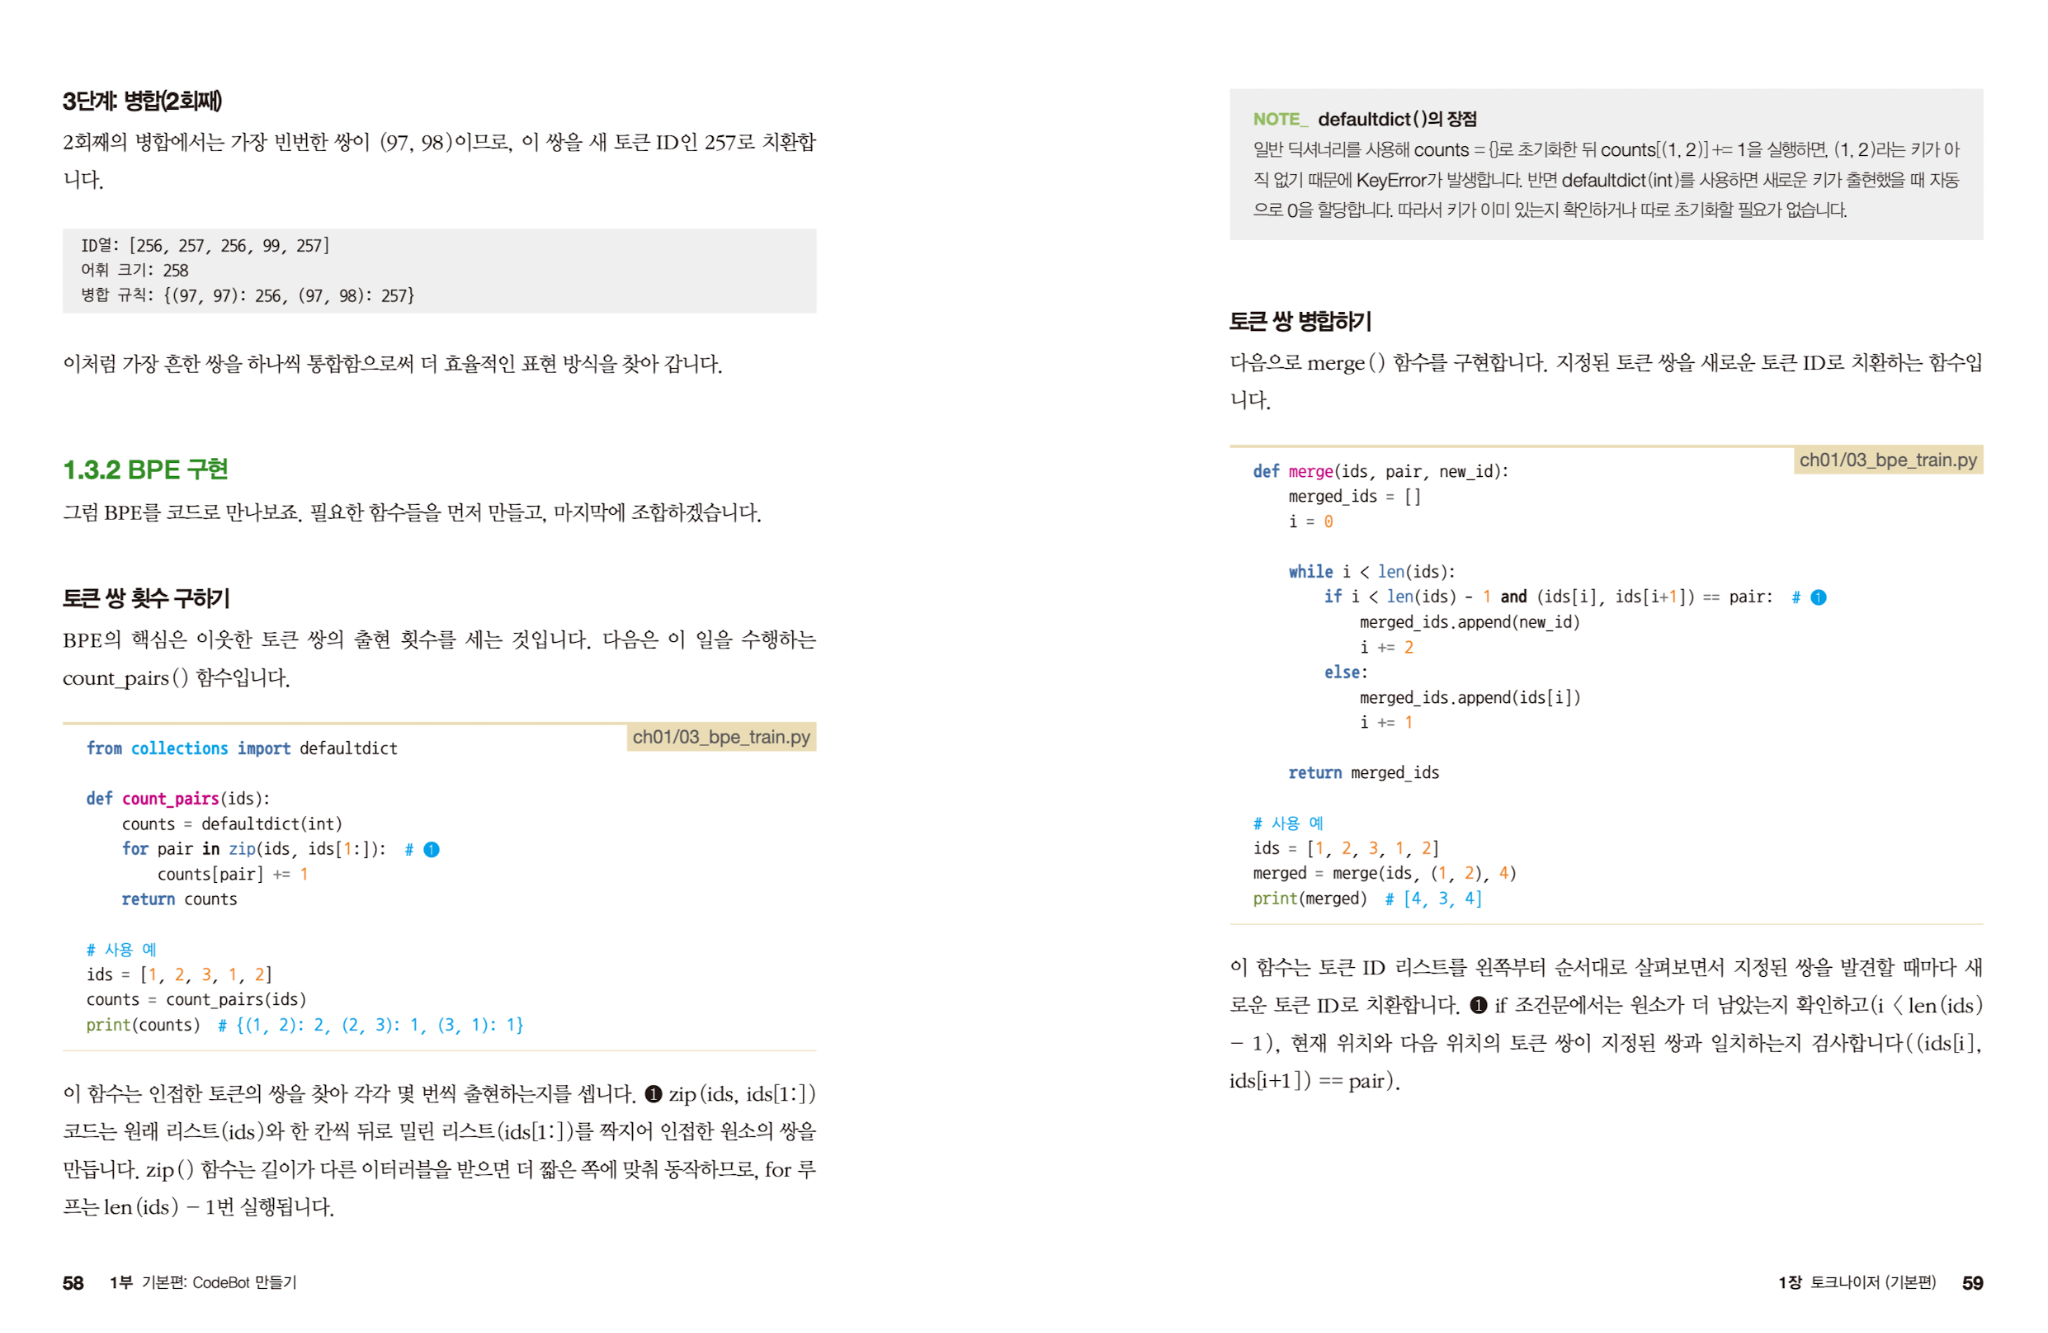
책을 보면서 가장 먼저 '역시 밑바닥부터 시리즈답다'고 느꼈던 부분은 토크나이저였다.
보통 BPE(Byte Pair Encoding)를 공부하면 "자주 등장하는 토큰 쌍을 반복적으로 병합한다" 정도로 원리를 이해하고 넘어가는 경우가 많다. 그런데 이 책에서는 실제 토큰 ID를 만들고, 인접한 토큰 쌍의 출현 횟수를 세고, 가장 많이 등장하는 쌍을 새로운 토큰으로 치환하는 코드부터 직접 구현한다.
예를 들어 어떤 쌍이 몇 번 등장하는지 count_pairs()로 세고, 가장 빈번한 토큰 쌍에 새로운 ID를 부여한 뒤 merge()를 통해 실제 토큰열을 변경하는 식이다.
BPE라는 이름 자체는 익숙했지만 이렇게 구현 단계를 따라가다 보니, '빈도가 높은 문자열 조각을 합친다'라는 설명이 실제 코드에서는 어떤 연산을 의미하는지가 훨씬 선명하게 들어왔다.
1부에서 만들고, 2부에서는 다시 뜯어고친다
1부에서는 우선 동작하는 CodeBot을 만드는 데 집중한다. BPE 토크나이저를 만들고, 어텐션과 트랜스포머를 구현하고, 사전 학습과 SFT를 거쳐 GRPO까지 진행한다. 그런데 2부 StoryBot으로 넘어가면 1부에서 만들었던 것들을 다시 꺼내서 하나씩 개선한다.
BPE 학습에서는 중복 제거, 부분 갱신, 분할 처리, 병렬화를 적용하고 대규모 데이터를 처리할 수 있도록 인코딩 과정까지 개선한다.
이런 구성이 단순히 "다음 장에서는 새로운 기술을 배운다"는 느낌보다 좋았다. 앞에서 만든 방식이 왜 규모가 커지면 문제가 되는지 확인하고, 그 문제를 해결하기 위해 실제 시스템이 어떻게 발전했는지를 따라갈 수 있기 때문이다.
실제 개발에서도 처음부터 완벽한 구조를 만드는 경우보다, 우선 동작하게 만든 뒤 병목을 찾아 개선하는 경우가 많다. 이 책 역시 비슷한 방식으로 진행되기 때문에 각각의 최적화 기술이 왜 등장했는지도 자연스럽게 이해할 수 있었다.
복잡한 어텐션도 그림 → 수식 → 코드 순서로 이어진다
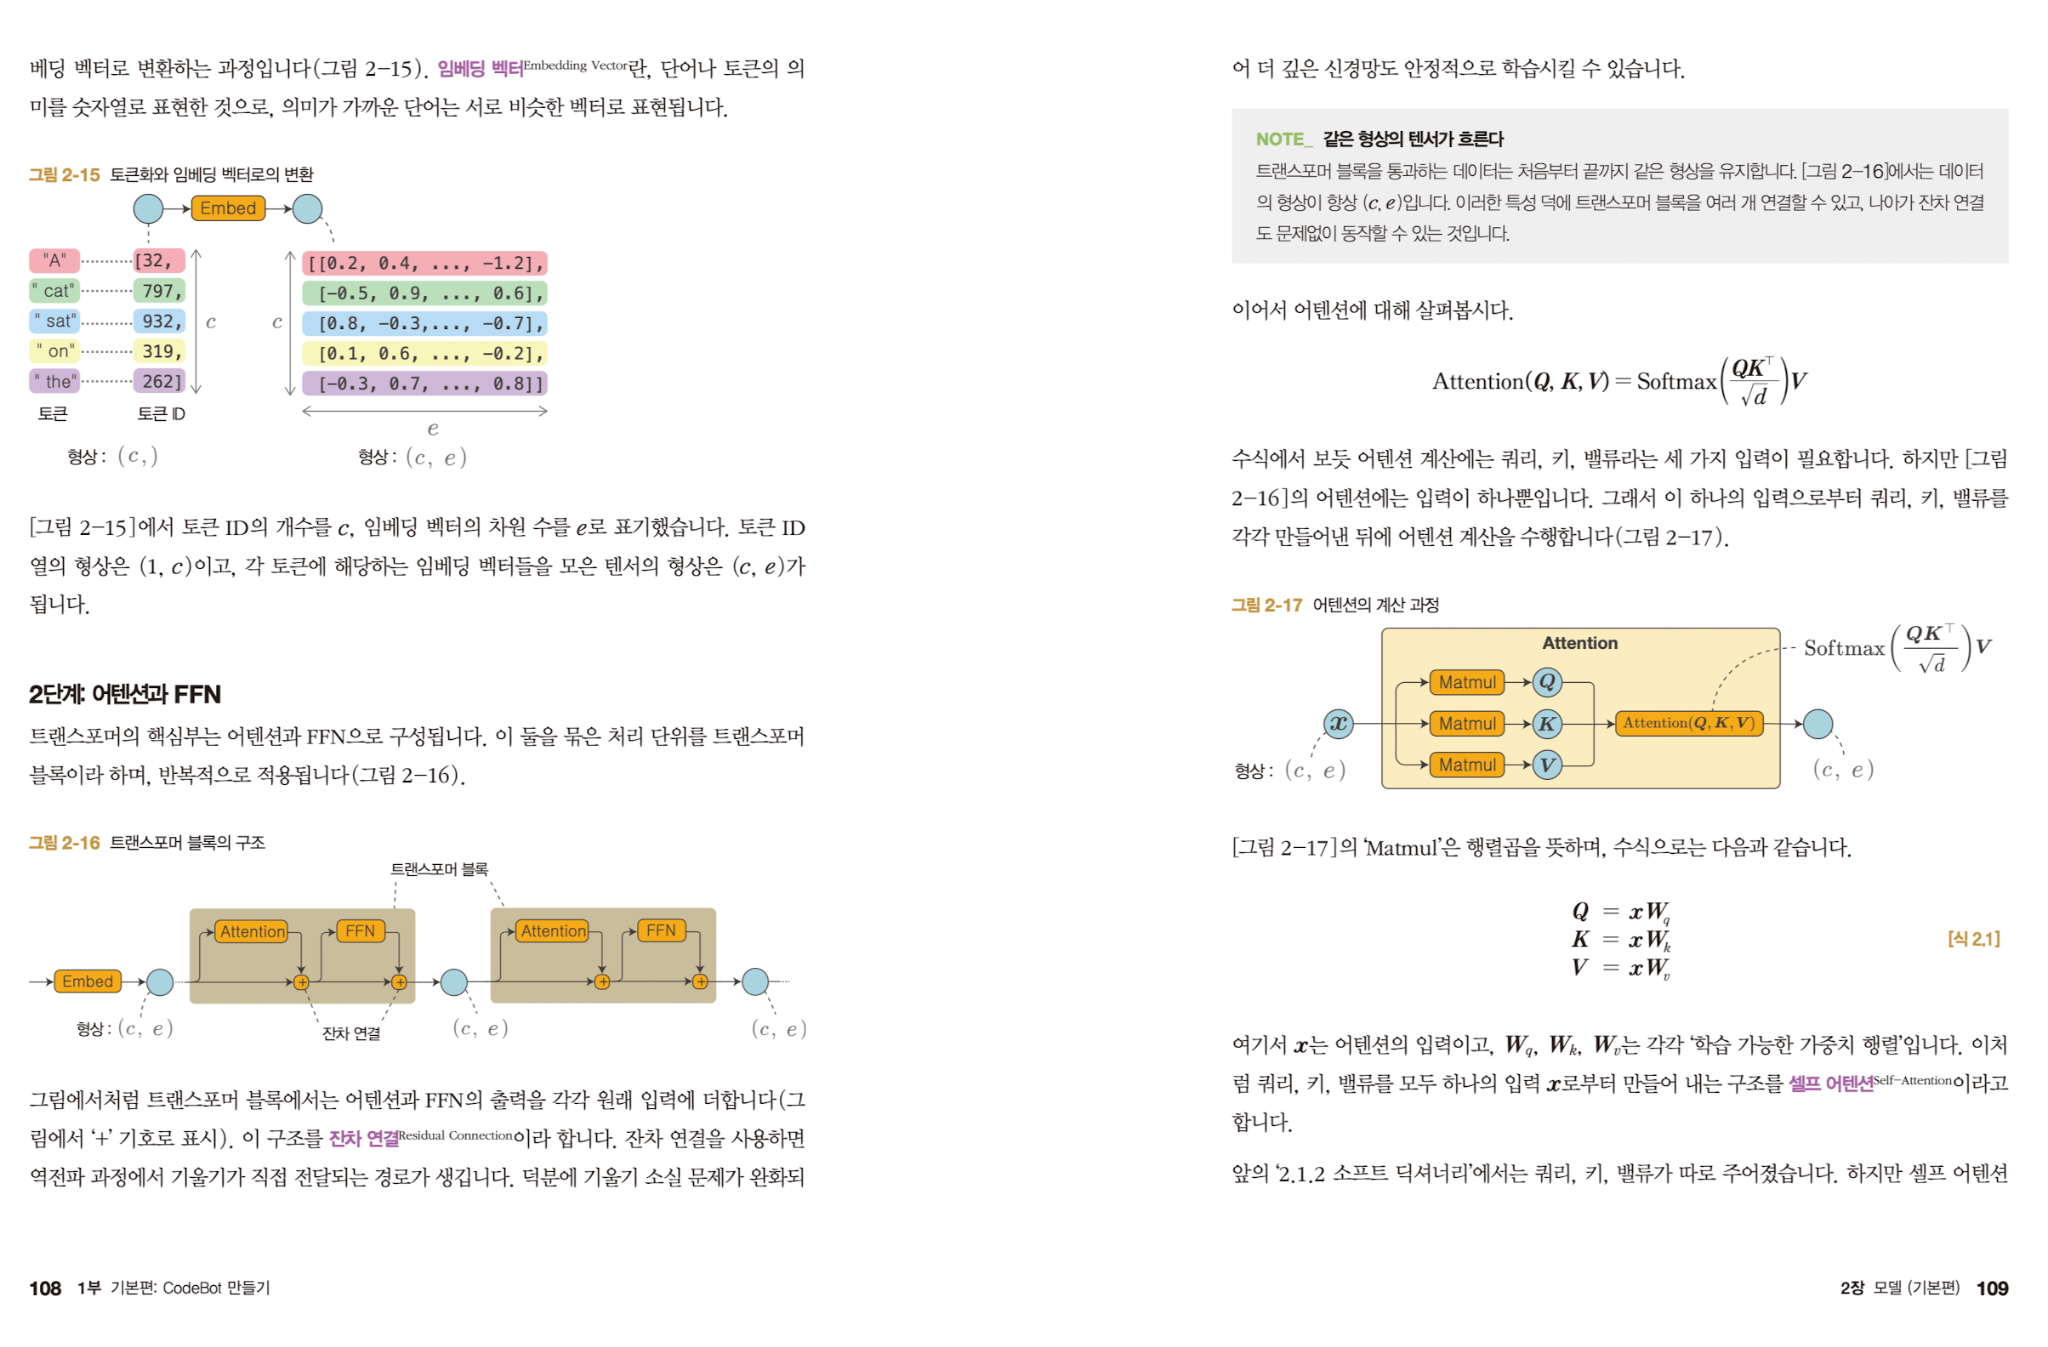
Q, K, V와 Softmax가 들어간 어텐션 수식만 보면 처음에는 꽤 추상적으로 느껴진다. 그런데 책에서는 텐서의 형태가 어떻게 변하는지 그림으로 먼저 보여주고, Q·K·V를 어떤 행렬곱으로 만드는지 설명한 뒤 실제 구현으로 이어간다.
트랜스포머 블록 역시 Attention과 FFN, Residual Connection이 어떻게 연결되는지를 그림으로 먼저 확인할 수 있다.
그래서 단순히 수식을 읽는 것보다 "이 텐서가 여기서 들어가서 어떤 형태로 나오고, 다음 블록으로 어떻게 전달되는가"를 따라가기가 훨씬 편했다.
LLM 구조를 처음 공부할 때 어려운 점 중 하나가 개별 개념은 이해해도 전체 데이터 흐름이 잘 연결되지 않는다는 것인데, 이 책은 그 부분을 코드와 그림을 같이 사용해 풀어낸다.
GPT의 기본 구조에서 RoPE, SwiGLU, KV Cache까지
모델 역시 1부에서는 비교적 기본적인 GPT 구조를 만든 뒤 2부에서 한 단계 더 현대적인 형태로 발전시킨다.
RoPE, SwiGLU, RMSNorm을 적용하고 개선된 GPT를 만든 뒤, KV Cache까지 구현한다. 따라서 "RoPE가 무엇이다", "SwiGLU가 무엇이다"라는 개별 설명에서 끝나는 것이 아니라 기존에 직접 만든 모델의 어느 부분을 바꾸는 기술인지를 비교하면서 볼 수 있다.
Optimizer도 비슷하다. 앞에서 기본적인 학습 과정을 경험한 뒤 AdamW의 원리와 구현, 학습률 스케줄, 혼합 정밀도 같은 실제 학습 과정에 필요한 요소들이 추가된다.
3부까지 가면 FlashAttention, GQA, MoE, torch.compile, 기울기 누적, 체크포인트, 분산 학습, ZeRO까지 등장한다.
결국 책 전체가 하나의 모델을 점점 현실적인 LLM에 가까운 형태로 키워나가는 구조다.
GRPO에서 DPO까지, 사후 학습도 직접 따라간다
1부에서는 강화 학습의 기초인 정책 경사법부터 출발해 베이스라인, 오프-정책, 클리핑을 거쳐 GRPO까지 진행한다. 요즘 LLM 이야기를 보다 보면 GRPO라는 단어가 자주 등장하지만 결과만 보는 것과 정책 경사부터 직접 따라가보는 것은 확실히 느낌이 달랐다.
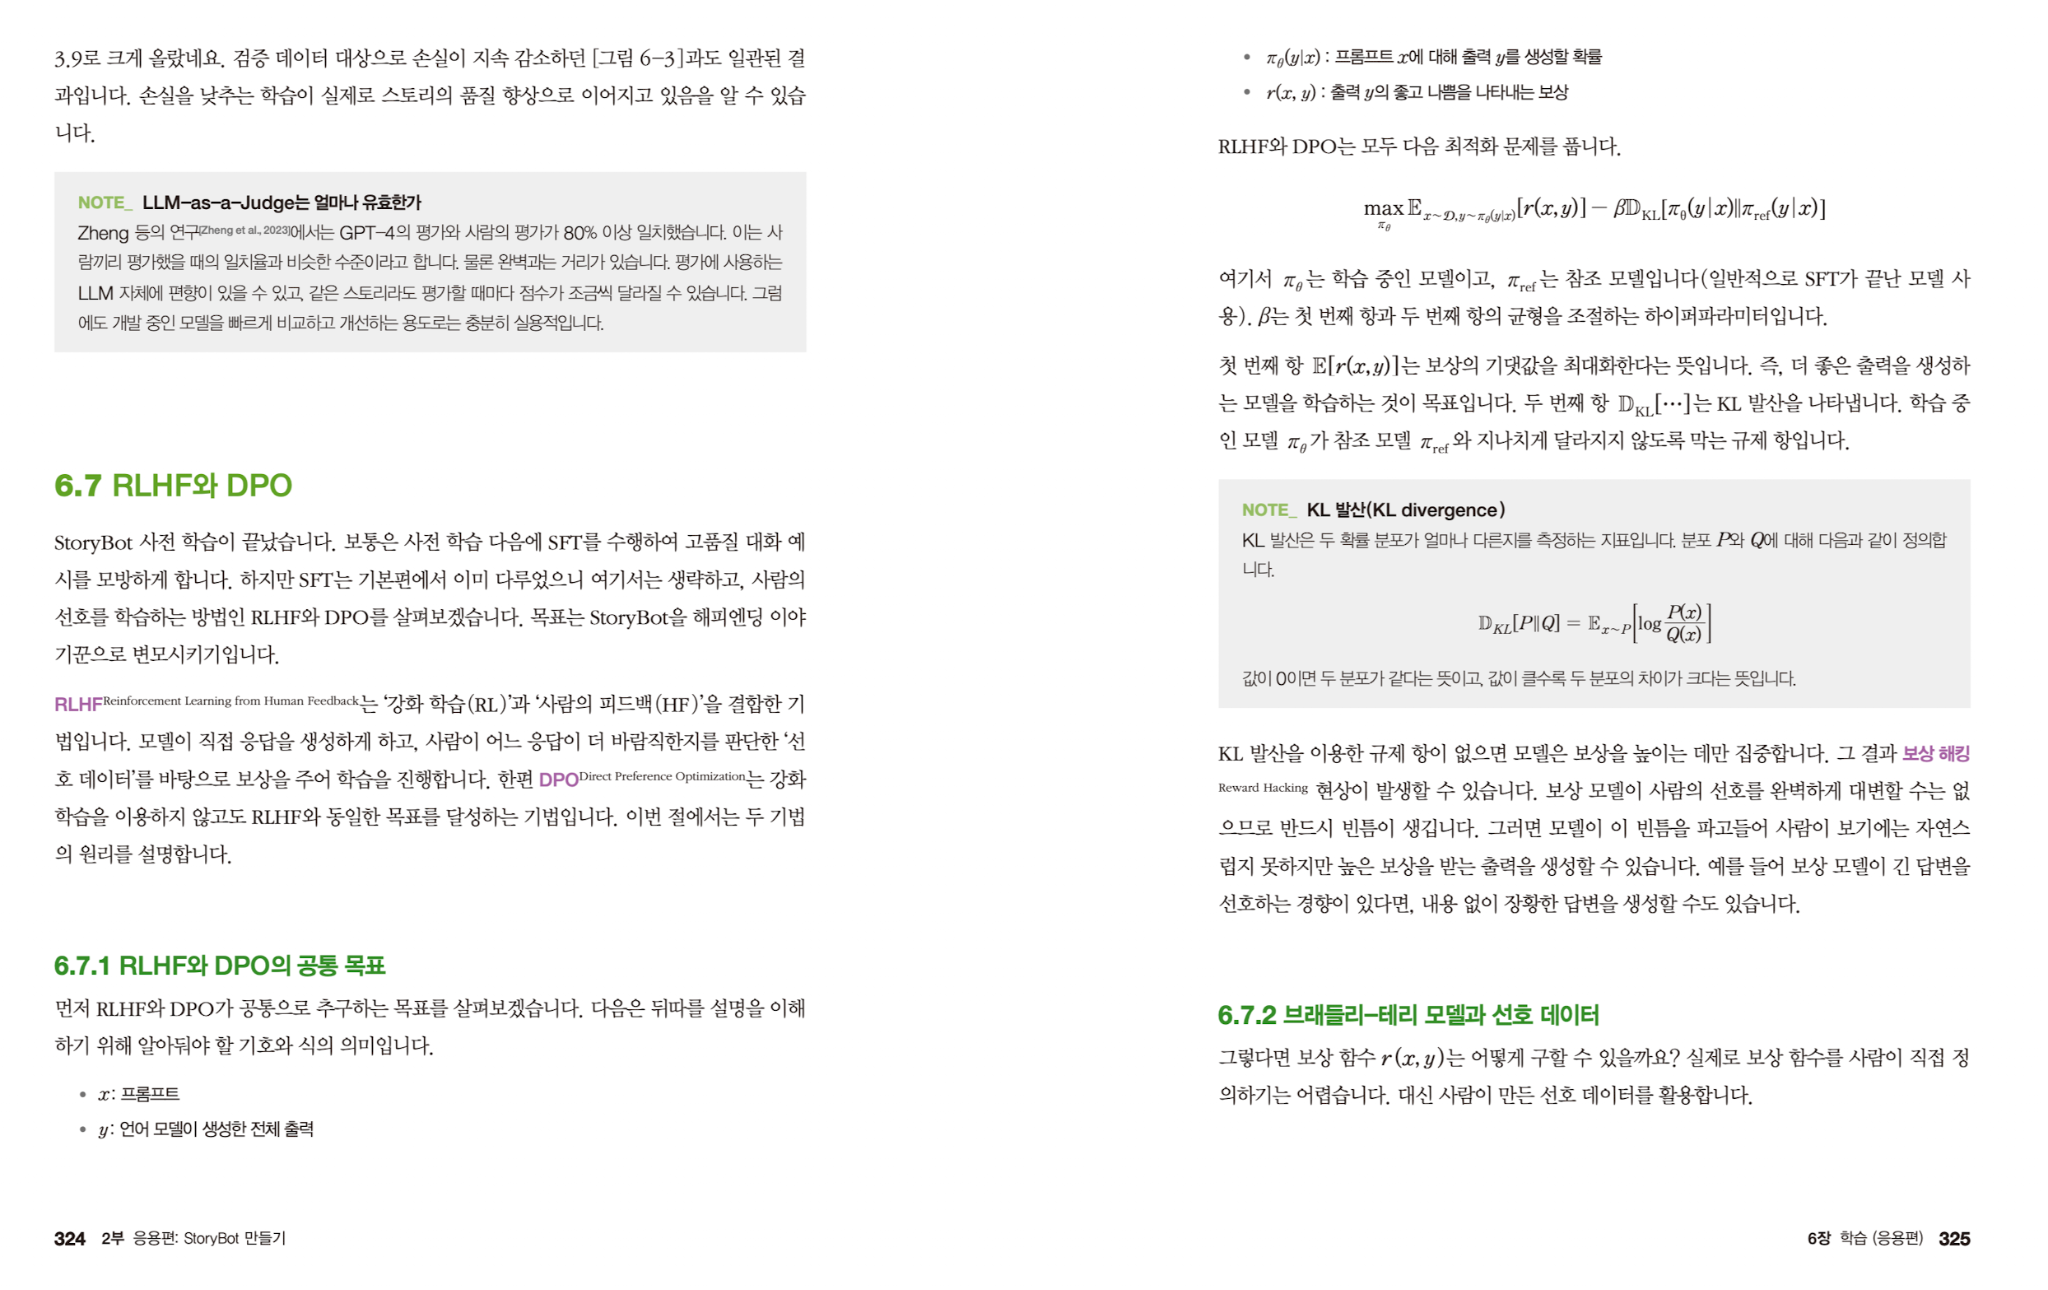
2부에서는 RLHF와 DPO로 확장되고, 모델 평가에서는 LLM-as-a-Judge처럼 사람이 모든 결과를 직접 평가하지 않고 LLM을 평가자로 활용하는 방법도 다룬다.
물론 LLM-as-a-Judge가 사람의 평가를 완전히 대체하는 것은 아니고 편향이나 일관성 등의 한계도 있다. 책에서도 이런 점을 함께 짚는다. 그래서 단순히 새로운 기법 이름을 소개하는 데 그치지 않고, 현재 LLM을 학습하고 평가하는 과정이 어떻게 구성되는지를 한 흐름 안에서 볼 수 있다는 점이 좋았다.
사실 '새로운 기술'을 알려주는 책은 아니다
이 책에서 다루는 BPE, Transformer, RoPE, SwiGLU, AdamW, DPO, FlashAttention, GQA, MoE 같은 기술들은 이미 널리 알려져 있고, 관련 내용을 다루는 책이나 자료도 적지 않다.
그래서 새로운 LLM 기술이나 최신 논문의 아이디어를 빠르게 훑기 위한 책을 찾는다면 방향이 조금 다를 수 있다.
대신 이 책의 가치는 이미 존재하는 기술을 A부터 Z까지 직접 연결해본다는 데 있다.
토크나이저는 따로 알고, Transformer도 따로 알고, SFT와 DPO도 따로 알고 있는 상태와 이 모든 요소가 하나의 모델을 만드는 과정에서 어떻게 연결되는지를 직접 구현해본 상태는 꽤 다르다고 생각한다.
특히 책의 절반 가까이를 차지하는 1부만 제대로 이해해도 LLM의 기본 동작 원리는 상당 부분 잡을 수 있다.
그 이후 2부와 3부는 "기본 LLM이 어떻게 동작하는가"보다는 그 LLM을 더 효율적으로 학습하고, 더 큰 데이터와 모델로 확장하려면 무엇을 바꿔야 하는가에 가까웠다.
최신 모델을 볼 때 기술의 위치가 조금씩 보이기 시작한다
이 책을 읽고 얻을 수 있는 가장 큰 장점 중 하나는, 최신 LLM의 기술 문서를 볼 때 새로운 기술이 기존 구조의 어느 부분을 바꾼 것인지 조금씩 보이기 시작한다는 점이다.
예를 들어 Kimi K2를 보면 1조 개가 넘는 전체 파라미터 중 일부만 활성화하는 MoE 구조를 사용하고, 어텐션에는 MLA(Multi-head Latent Attention)를 적용했다. 특히 학습에서는 익숙한 AdamW 대신 Muon을 대규모 학습에 맞게 확장한 MuonClip을 사용했다. 책 후반부에서 MoE와 Muon 옵티마이저를 직접 다루기 때문에, 이런 내용을 봤을 때도 단순히 새로운 용어로 받아들이기보다 “아, 모델 구조에서는 MoE와 MLA를 쓰고, 학습 최적화에서는 Muon 계열을 선택했구나”라고 위치를 잡아볼 수 있다.
최근 GLM-5.3-Flash도 비슷하다. 이 모델은 320B 규모의 MoE 구조에 sparse attention과 linear attention을 결합한 하이브리드 어텐션을 사용하고, 긴 컨텍스트를 효율적으로 처리하기 위한 구조적 개선을 적용했다.
결국 이 책을 통해 모든 최신 기술을 배우는 것은 아니다. 오히려 중요한 건 새로운 모델이 나왔을 때 비교할 수 있는 기준점이 생긴다는 것에 가깝다. 1부에서 LLM의 기본 구조를 제대로 이해해두면 이후 최신 논문을 읽을 때도 “완전히 새로운 모델”이라기보다 기존 구조에서 무엇을 유지하고 무엇을 바꿨는지를 중심으로 볼 수 있다는 점이 특히 좋았다.
이런 사람에게 특히 잘 맞을 것 같다
LLM API를 사용하는 데는 익숙하지만 내부에서 실제로 무엇이 일어나는지는 한 번 제대로 정리해보고 싶은 개발자라면 특히 재미있게 볼 수 있을 것 같다. 또한 Transformer나 BPE, RoPE, DPO 같은 개념을 각각 공부해본 적은 있지만 서로 어떻게 연결되는지가 아직 흐릿한 사람에게도 도움이 될 것 같다.
반대로 딥러닝을 처음 접하는 사람보다는, 이미 파이썬과 파이토치를 어느 정도 사용해봤고 이제 'LLM 하나가 실제로 어떻게 만들어지는지 처음부터 끝까지 한번 직접 보고 싶다'는 사람에게 더 잘 맞는 책이라고 생각한다.
나 역시 이 책을 읽으면서 새로운 기술 이름을 많이 알게 됐다기보다는, 그동안 따로 알고 있던 기술들의 위치가 하나의 그림 안에서 연결된 점이 가장 좋았다.
이제 논문이나 새로운 모델의 기술 문서를 볼 때도 단순히 "새로운 기술이 나왔구나"에서 끝나는 것이 아니라, 기존 LLM의 어느 부분을 무엇으로 바꾼 것인지를 조금 더 구체적으로 볼 수 있을 것 같다.


댓글